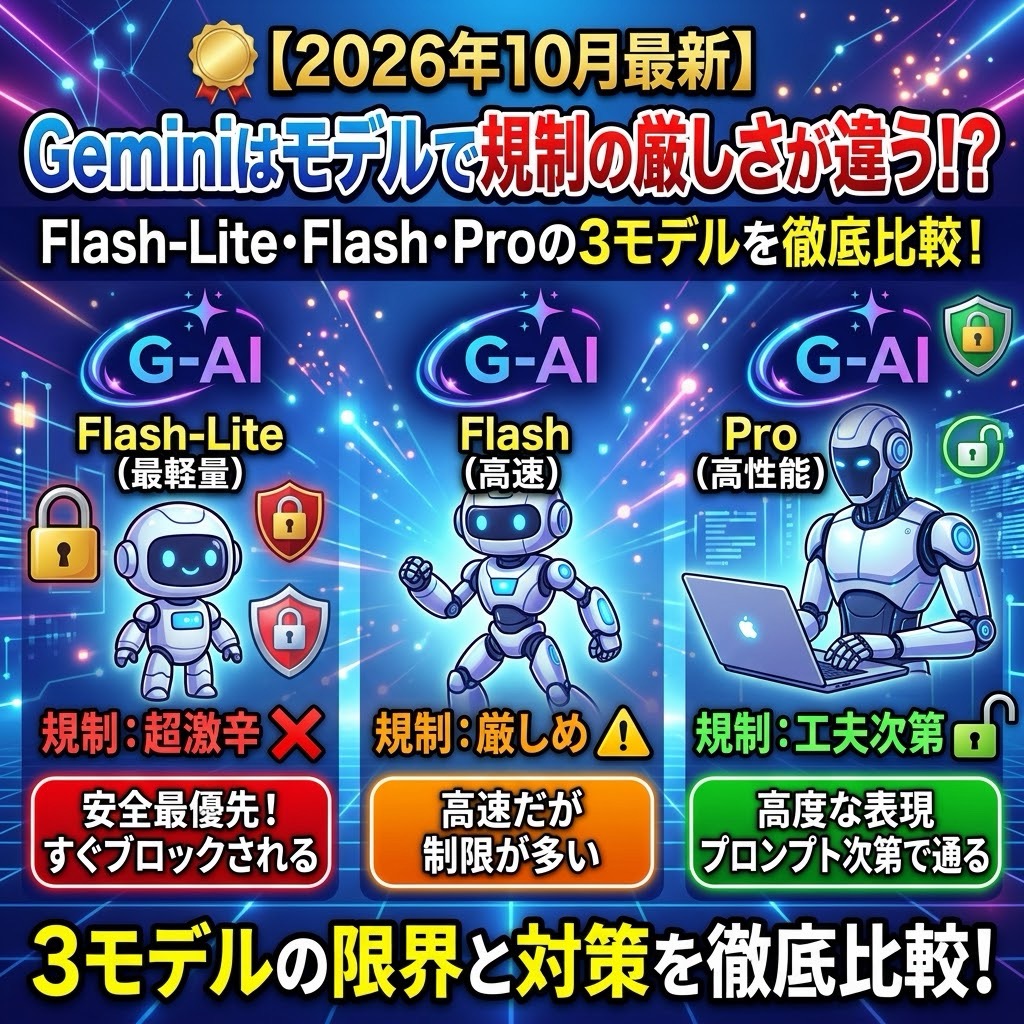
本日からGemini無料版はFlash-Liteのみになりました
2026年10月9日から、Geminiのプラン別利用モデルが変更されました。Google AIに未加入の無料ユーザーが使えるのはFlash-Liteのみになり、FlashやProといった上位モデルは有料プラン限定になっています。
この変更で一気に増えたのが、「モデルによって規制の厳しさは違うのか」**という疑問です。
- 「上位モデルのほうが厳しいのでは」
- 「軽量モデルのほうが緩いという話を聞いた」
- 「モデルを変えたら書けなくなった」
この記事では、公式ドキュメントで確認できることと、実際に触ってみた体感を分けて整理します。この2つを混ぜると判断を間違えるので、どちらの話なのかを明示しながら進めます。
結論:公式仕様では「同じ」、体感では「違う」
先に結論をお伝えします。
公式仕様上、モデル階層によって安全フィルタの基準が分けられているという記載はありません。 一方で、実際に触ると体感は変わります。
矛盾しているように見えますが、理由があります。順に見ていきます。
公式ドキュメントが示していること
まず事実の確認です。
安全設定のデフォルトはモデル階層で分かれていません
Gemini APIの公式ドキュメントには、安全設定のしきい値についてこう記載されています。
しきい値が設定されていない場合、Gemini 2.5および3系モデルのデフォルトのブロックしきい値はOffです
ここで重要なのは、「Flash-Liteは◯◯、Proは◯◯」という階層ごとの区分が存在しないという点です。世代(2.5系・3系)でまとめて規定されており、同一世代の中で階層別に基準が分けられてはいません。
つまり「Proだから規制が厳しく設定されている」という公式な根拠は、確認できません。
中核的な保護は全モデル共通で、常時オンです
ただし、調整できない領域があります。
児童の安全に関わる保護は、全モデルで常時有効であり、設定で変更できません。 これはモデルを変えても、設定をどう触っても、一切変わりません。
ウェブ版Geminiには調整項目がほぼありません
もう一点、見落とされがちな事実があります。
上で説明した安全設定は、API・AI Studioといった開発者向け環境の話です。 通常のウェブ版・アプリ版のGeminiには、ユーザーが安全設定を調整する項目はほぼ用意されていません。
「設定を変えれば緩くなる」という話は、一般ユーザーが使う画面には存在しないと理解しておいてください。
公式に差があるのは「安全性」ではなく「思考の仕方」です
ではモデル間で何が違うのか。公式に明示されている差は、推論能力と応答速度です。
モデル選択画面の表記を見ると、性格の違いがはっきり表れています。
| モデル | 画面上の説明 | 位置づけ |
|---|---|---|
| 3.5 Flash-Lite | すばやく回答を得るのに最適 | 最軽量・最速。初回応答が速い |
| 3.8 Flash | あらゆる場面でサポート | バランス型。現在の標準 |
| Pro | (上位プラン限定) | 最上位の推論性能 |
Flash-Liteは初回応答までの速度が大幅に速い設計で、短い要約や書き換えのような軽い処理に向いています。一方のProは、複雑な指示や長い文脈を扱う推論性能で上位にあります。
押さえておくべき重要な仕様
ここは知っておくと得をする部分です。
Flashの思考レベルを上げても、モデルそのものの能力は上がりません。
処理能力を「低・中・高」から選べる仕様がありますが、これは与えられた能力の範囲内でどれだけ考えるかを変えるだけです。モデル自体の上限は動きません。
能力そのものを上げたいなら、Proに替える以外に方法はないということになります。「Flashの思考レベルを高にすればPro相当になる」という理解は誤りです。
実際に触ってみた体感
ここからは、当サイトで実際に触った範囲の話です。公式仕様ではなく体感であることを前置きしておきます。
一言でまとめると、こうなりました。
- 即答型のモデル(Flash-Lite) — 比較的そのまま通る場面が多い
- 熟考型のモデル(Pro) — 答える前に止まる場面が増える
- Flash — その中間にあたる感触
つまり**「速く答えるモデルほど素直に書く」「考えてから答えるモデルほど手前で止まる」**という傾向を感じました。
ただし繰り返しますが、これは体感であって公式仕様ではありません。 再現性も保証できませんし、同じプロンプトでも日によって結果が変わります。
なぜ体感差が生まれるのか
公式に基準が分かれていないのに体感が変わる。この理由について、ドキュメントから読み取れる手がかりが3つあります。
①生成は出力中も監視されています Geminiは入力段階だけでなく、文章を出力している最中にも判定が行われます。途中まで書いて止まる挙動があるのは、このためです。
②判定は「確率」で行われます Geminiの安全判定は、内容の深刻さではなく**「有害カテゴリに属する確率」**で行われます。つまり同じ文章でも、モデルの解釈によって確率の見積もりが変わり得るということです。
③熟考するモデルは、答える前に方針を検討します Proのような推論重視のモデルは、応答を出す前に内部で検討の工程を踏みます。この工程が、自己点検の機会を増やしている可能性があります。即答型のモデルにはこの工程が薄いわけです。
モデルごとの「安全基準」が違うのではなく、「同じ基準に対する解釈の精度」が違う——この見方が、現時点で最も筋が通ります。
【最重要】モデルを変えても絶対に通らない領域があります
ここは他の話とまったく次元が違うので、独立して書きます。
次の3つは、どのモデルを選んでも、どう工夫しても通りません。
- 未成年に関わる性的表現
- 実在の人物を対象にした内容
- 非同意を前提とした内容
特に①については、全モデルで常時有効・設定変更不可の保護が公式に明記されています。モデル階層の話とは完全に別枠です。
そしてここはアカウント停止で済む領域ではありません。 通報・法的責任の問題に直結します。「成人設定と書けば大丈夫」という話でもなく、見た目・年齢を想起させる語・学生という設定などが含まれれば判定対象になります。
ここは「どのモデルなら通るか」を探る領域ではありません。 一切近づかないでください。
モデル選びより効いてくるもの
ここまでモデルの話をしてきましたが、率直に言うと、モデル選びで変わるのは全体のごく一部です。
実際に小説を書いていると、ぶつかる壁はこちらのほうが多いはずです。
- 文章が薄い。描写が深まらない
- 指定した文字数に届かない
- 途中で文体や設定が崩れる
- 同じことを何度も書かれる
- そもそも書き始めてくれない
これらはモデルを変えても解決しません。 指示の出し方の問題だからです。
実際、Flash-Liteのような軽量モデルでも、指示の設計次第で実用的な出力は得られます。逆にProを使っていても、投げ方が雑なら薄い文章しか返ってきません。
モデルは入口にすぎず、出てくるものの質を決めているのはプロンプトの組み方です。
具体的な方法をまとめた教材があります
この部分について、当サイトでは実践的な内容を1冊にまとめています。
『Geminiで官能小説を書く方法完全版』(2,980円)
収録している内容は次のとおりです。
- 垢BAN対策 — 何を避ければリスクを下げられるのか
- 高品質な小説を書く方法 — 薄い文章が出てくる原因と、その解消手順
- 「魔法のプロンプト」の解説 — 実際に使っている指示文の組み立て方
- 2026年9月時点の最新仕様に対応
記事では書ききれない、実際の指示文そのものを扱っています。モデルを変えても状況が変わらなかった方は、こちらを確認してみてください。
モデルの選び方(結論)
最後に実用的な指針を整理します。
無料のままで使う場合 Flash-Liteのみになりますが、指示の設計で補える部分は大きいです。短い場面を区切って書かせる、条件を分けて投げるといった工夫で実用レベルに持っていけます。
文章の深さが足りないと感じる場合 AI Plus(月額725円)でFlashに戻すのが最も安い解決策です。思考レベルを上げるのではなく、モデル自体を上げることが必要だという点を思い出してください。
長編を安定して書きたい場合 Proが使えるAI Pro(月額2,900円)が選択肢になります。ただし**「上位モデルにすれば通りやすくなる」わけではない**点はご注意ください。体感としては、むしろ逆の傾向を感じました。
まとめ
- 公式仕様上、モデル階層ごとに安全フィルタの基準が分けられているという記載は確認できません。デフォルトのしきい値は世代単位で規定されています
- 児童の安全に関わる保護は全モデルで常時有効・調整不可です
- ウェブ版Geminiには、そもそもユーザーが安全設定を触る項目がほぼありません
- 公式に差があるのは推論能力と応答速度。Flash-Liteは最速・最軽量、Flashはバランス型、Proが最上位です
- Flashの思考レベルを上げてもモデルの能力は上がりません。能力を上げるならProに替える必要があります
- 体感としては、即答型のモデルほど素直に通り、熟考型ほど手前で止まる傾向を感じました。ただしこれは体感であり、公式仕様ではありません
- 体感差の理由として考えられるのは、出力中も監視されている、判定が確率で行われる、熟考するモデルは自己点検の機会が多いという3点です
- 未成年・実在人物・非同意は、どのモデルでも例外なく通りません
- そしてモデル選びで変わるのは一部分です。文章の薄さや文字数不足は、指示の出し方で決まります
Geminiの仕様は頻繁に変更されます。この記事は2026年10月時点の内容ですので、最新の仕様は公式でご確認ください。
コメント